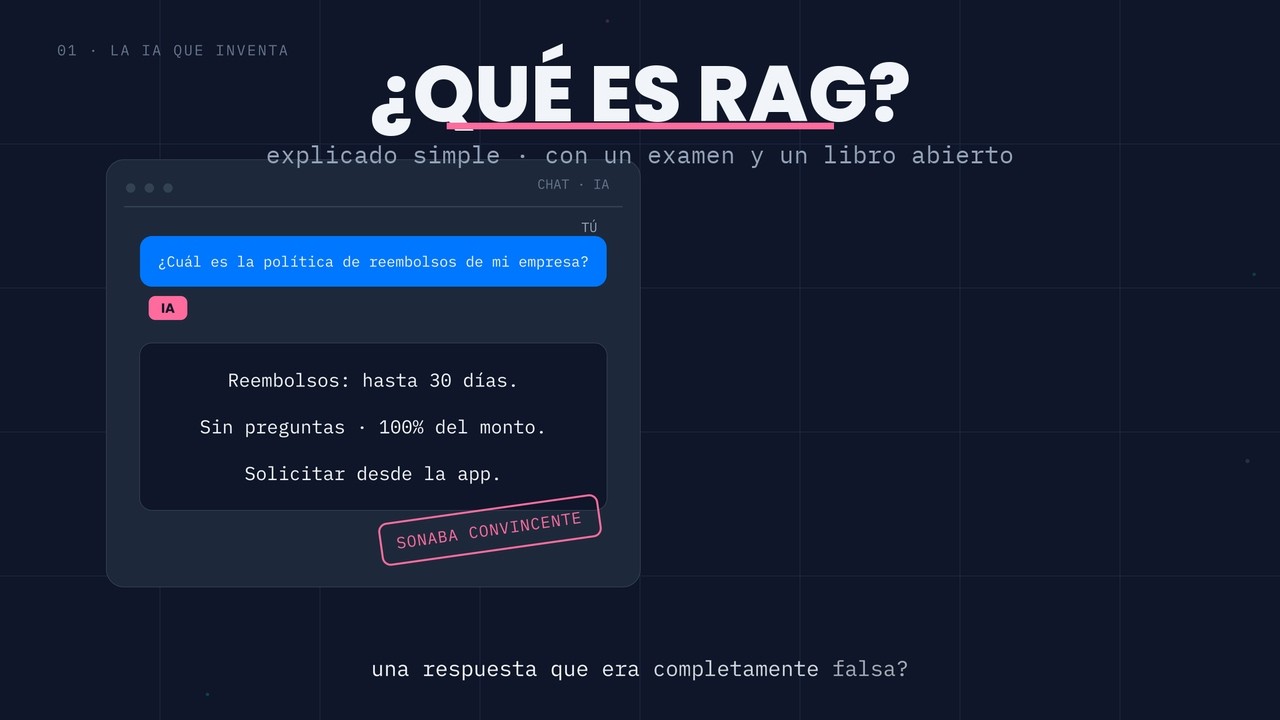
¿Alguna vez le preguntaste algo a una IA sobre tu empresa — tu política de reembolsos, tus horarios, tus precios — y te respondió con total seguridad una respuesta que era completamente inventada? No es un bug: es lo que pasa cuando le pides a un modelo que responda sobre algo que no sabe. La IA no conoce tu empresa, tus documentos ni lo que pasó ayer. Y aun así, prefiere inventar antes que decir "no sé".
A eso se le llama alucinación, y tiene cura parcial. Se llama RAG: Retrieval-Augmented Generation, o generación aumentada por recuperación. Es la técnica que usan los chatbots serios para responder con información real de un negocio en vez de con memoria. En este post te explico qué es, cómo funciona por dentro, y las decisiones de implementación que separan un RAG que responde bien de uno que busca mal.
Como los anteriores, este post tiene su video en YouTube — es la parte 3 de la serie (WebSocket, Webhooks).
El problema de fondo: la IA responde de memoria
Un modelo de lenguaje como los que potencian ChatGPT o los bots modernos aprendió de una cantidad enorme de texto durante su entrenamiento. Ese conocimiento tiene tres límites que explican casi todas las respuestas raras:
- Tiene fecha de corte: no sabe nada de lo que pasó después de su entrenamiento.
- Es público: sabe mucho de internet, pero nada de tus documentos internos, tu catálogo o las políticas de tu empresa.
- No sabe que no sabe: un modelo está entrenado para producir texto plausible. Ante una pregunta que no puede responder, no se calla — genera la respuesta más parecida a una verdad.
La metáfora exacta es un examen de memoria: el estudiante contesta con lo que recuerda, y si no se acuerda... adivina. A veces adivina bien. Y el problema de las respuestas inventadas no es solo que sean falsas — es que suenan igual de convincentes que las verdaderas.
La idea del RAG: examen con libro abierto
RAG convierte el examen de memoria en un examen con libro abierto. Antes de responder, el sistema busca en tus documentos los fragmentos relevantes y se los entrega al modelo junto con la pregunta. El modelo ya no inventa tu política de reembolsos: la lee y la explica.
El nombre lo describe pieza por pieza:
- Retrieval (recuperación): buscar los fragmentos correctos en tus documentos.
- Augmented (aumentada): la pregunta del usuario se aumenta con esos fragmentos.
- Generation (generación): el modelo genera la respuesta apoyándose en lo que le acabas de dar.
La consecuencia más importante: la respuesta queda limitada por lo que dicen tus documentos. El modelo sigue escribiendo bien (esa es su fortaleza), pero la información viene de tu fuente de verdad, no de su memoria.
Cómo funciona, en 4 pasos
Paso 1 — Cortar tus documentos en fragmentos. Un manual de 80 páginas no se le puede entregar completo al modelo en cada pregunta. Lo que se hace es partir los documentos en fragmentos (chunks) de tamaño manejable: un párrafo, una sección, un par de cientos de palabras. Este paso parece trivial y es de los más delicados — volveremos a eso.
Paso 2 — Convertir cada fragmento en números (embeddings). Cada fragmento pasa por un modelo de embeddings que lo convierte en una huella numérica: un vector de cientos o miles de números que captura su significado. Dos textos que hablan de lo mismo tienen huellas cercanas, aunque usen palabras distintas. "Política de devoluciones" y "cómo reclamar tu reembolso" terminan siendo vecinas. Estas huellas se guardan en una base de datos vectorial (en nuestro caso, Postgres con pgvector).
Paso 3 — Buscar los fragmentos más parecidos a la pregunta. Cuando alguien pregunta "¿en cuántos días puedo devolver un producto?", la pregunta también se convierte en huella, y la base busca los fragmentos cuya huella está más cerca. Es un búsqueda por similitud de significado, no por palabras exactas: encuentra el fragmento correcto aunque el usuario haya preguntado con otras palabras.
Paso 4 — Responder con evidencia. La pregunta original y los 3–5 fragmentos recuperados entran juntos al modelo, con una instrucción del tipo "responde usando esta información". El modelo redacta la respuesta apoyándose en el texto real — con suerte citando de dónde salió.
| Paso | Qué pasa | Por qué importa |
|---|---|---|
| 1. Chunking | Partir documentos en fragmentos | Define la unidad de búsqueda y de respuesta |
| 2. Embeddings | Fragmento → huella numérica | Permite comparar por significado |
| 3. Retrieval | Buscar las huellas más cercanas a la pregunta | Decide QUÉ información ve el modelo |
| 4. Generación | Pregunta + fragmentos → respuesta | El modelo redacta, pero con evidencia |
Dónde se usa
Si has usado un asistente que responde cosas que no podrían estar en el entrenamiento de un modelo, casi seguro había RAG detrás:
- Atención al cliente: bots que responden con las políticas, horarios y precios reales del negocio — no con suposiciones.
- Asistentes de documentos internos: pregúntale a tus manuales, contratos o wikis en lenguaje natural.
- Revisión de contratos: encontrar las cláusulas relevantes entre cientos de páginas, citando la página exacta.
- Chatbots de WhatsApp para negocios: el caso que más nos toca — un bot que conoce tu catálogo y tus condiciones porque le subiste tus documentos.
Lo que nadie te cuenta: la búsqueda lo es todo
La parte que los tutoriales no muestran: en un RAG real, la calidad vive o muere en el paso 3. El modelo final es casi lo de menos. Cinco lecciones que aprendimos construyendo RAG de verdad:
1. El chunking decide la calidad. Fragmentos muy grandes: la búsqueda devuelve bloques llenos de relleno y el modelo se distrae. Fragmentos muy chicos: la respuesta correcta quedó partida en dos trozos y ninguno alcanza. Y si tus documentos están en español pero tu búsqueda solo entiende bien inglés, el sistema entero busca a medias. No es detalle menor: es la diferencia entre un bot que responde y un bot que parece roto.
2. La similitud semántica pura no alcanza. La búsqueda por significado es genial para "¿cómo reclamo mi plata?" → "política de reembolsos". Pero falla estrepitosamente con nombres propios, SKUs y términos exactos: "MysticaL Terra v2" no tiene un "significado" útil para comparar. Por eso los sistemas serios usan búsqueda híbrida: resultados semánticos (por significado) + resultados léxicos (por palabras exactas), fusionados con un algoritmo de ranking como RRF (Reciprocal Rank Fusion). Lo mejor de los dos mundos.
3. La actualización no es opcional. Un RAG responde con lo que hay en la base. Si subiste los precios de 2024 y cambió el catálogo, el bot responde con información vieja con total seguridad. La base de conocimiento necesita un ciclo de vida: subir, actualizar, ver qué documentos responde mal.
4. RAG reduce las alucinaciones; no las elimina. Con evidencia delante, el modelo inventa muchísimo menos — pero sigue siendo un modelo de lenguaje. La defensa final es la misma que en cualquier sistema serio: pedirle que cite la fuente, limitar la respuesta a los documentos, y monitorear qué responde.
5. La infraestructura importa menos de lo que crees. No necesitas una base vectorial exótica: Postgres con la extensión pgvector alcanza para la mayoría de los casos, y te ahorra operar un sistema más. El valor está en el pipeline de ingesta y en la calidad de la búsqueda, no en la base de datos de moda.
Un caso real: los bots de UseFlowy responden con tus documentos
Esto es exactamente lo que hace la función de bases de conocimiento de UseFlowy. El flujo:
- Subes tus documentos — PDFs, textos, el contenido de tu web — a la base de conocimiento de tu bot.
- La plataforma los trocea, calcula sus embeddings y los guarda en Postgres con pgvector.
- Cuando un cliente pregunta por WhatsApp o por el chat web, la pregunta se busca en esa base con búsqueda híbrida (semántica + palabras clave, fusionadas con RRF).
- El bot redacta su respuesta con esa evidencia — no con su memoria.
Lo probamos con nuestro propio bot comercial: el bot del landing responde preguntas sobre planes, precios y límites del producto consultando los documentos reales del producto. Si el documento no lo dice, el bot no lo dice. Esa es la promesa del RAG bien hecho: un bot que responde como alguien que leyó tu manual, no como alguien que lo adivinó.
Lo vemos en video
Grabamos un video corto (2 minutos) con toda la parte conceptual animada: la IA que inventa, la metáfora del examen con libro abierto, los 4 pasos y los casos de uso:
👉 ¿Qué es RAG? Explicado simple
En resumen
- Una IA sin contexto responde de memoria — y cuando no sabe, inventa con la misma seguridad.
- RAG = primero recuperar los fragmentos relevantes de tus documentos, después generar la respuesta con esa evidencia.
- Funciona en 4 pasos: chunking → embeddings → búsqueda por similitud → generación con los fragmentos en el prompt.
- En producción, la calidad la decide la búsqueda: buen chunking, embeddings que entiendan tu idioma y búsqueda híbrida con RRF.
- RAG reduce drásticamente las alucinaciones, pero la regla de oro sigue siendo: fuentes visibles y base de conocimiento actualizada.
Si quieres un bot que atienda con la información real de tu negocio — no con inventos — sube tus documentos a una base de conocimiento y conéctala a tu bot: toma minutos. Crea tu bot gratis en UseFlowy y pregúntale tú mismo.
Parte 3 de la serie: WebSocket explicado · Webhook explicado · RAG (este post).